Renditeradar
Aggregator for investment properties: from the messy raw row to a radius search over a spatial index.
- Role
- Sole developer, work sample for a mandate
- Period
- September 2026, in one day
- Next.js 16
- React 19
- TypeScript
- Tailwind CSS v4
- PostgreSQL
- PostGIS
- Row Level Security
- Supabase
- Python 3.13
- Leaflet
- Vercel
- GitHub Actions
What it does
Beyond the first paragraph this page is still in German. A full translation is on its way.
A mandate asked for a property aggregator with scraping, key figures, filters, a yield calculator and a subscription model. Two of its requirements were not yet evidenced in the portfolio: Next.js with static generation for search engines, and PostgreSQL with fast filter and location queries. So this is not a small replica of the whole platform but exactly those two proofs, complete and verified, built in one day from the first commit at 00:54 to the last milestone at 16:03. Every claim has an executed proof: idempotency by a second pipeline run, index use by the query plan, the write ban by a rejected write with the public key.
Ausgeschrieben war ein Immobilien-Aggregator mit Scraping, Kennzahlen, Filtern, Renditerechner und Abo-Modell. Zwei Anforderungen daraus waren im Portfolio nicht belegt: Next.js mit statischer Erzeugung für Suchmaschinen, und PostgreSQL mit schnellen Filter- und Standortabfragen. Alles Übrige war es bereits. Also nicht ein kleines Abbild der ganzen Plattform, sondern genau diese zwei Belege, dafür vollständig und nachgewiesen. Umgesetzt an einem Tag, vom ersten Commit um 00:54 bis zum letzten Meilenstein um 16:03.
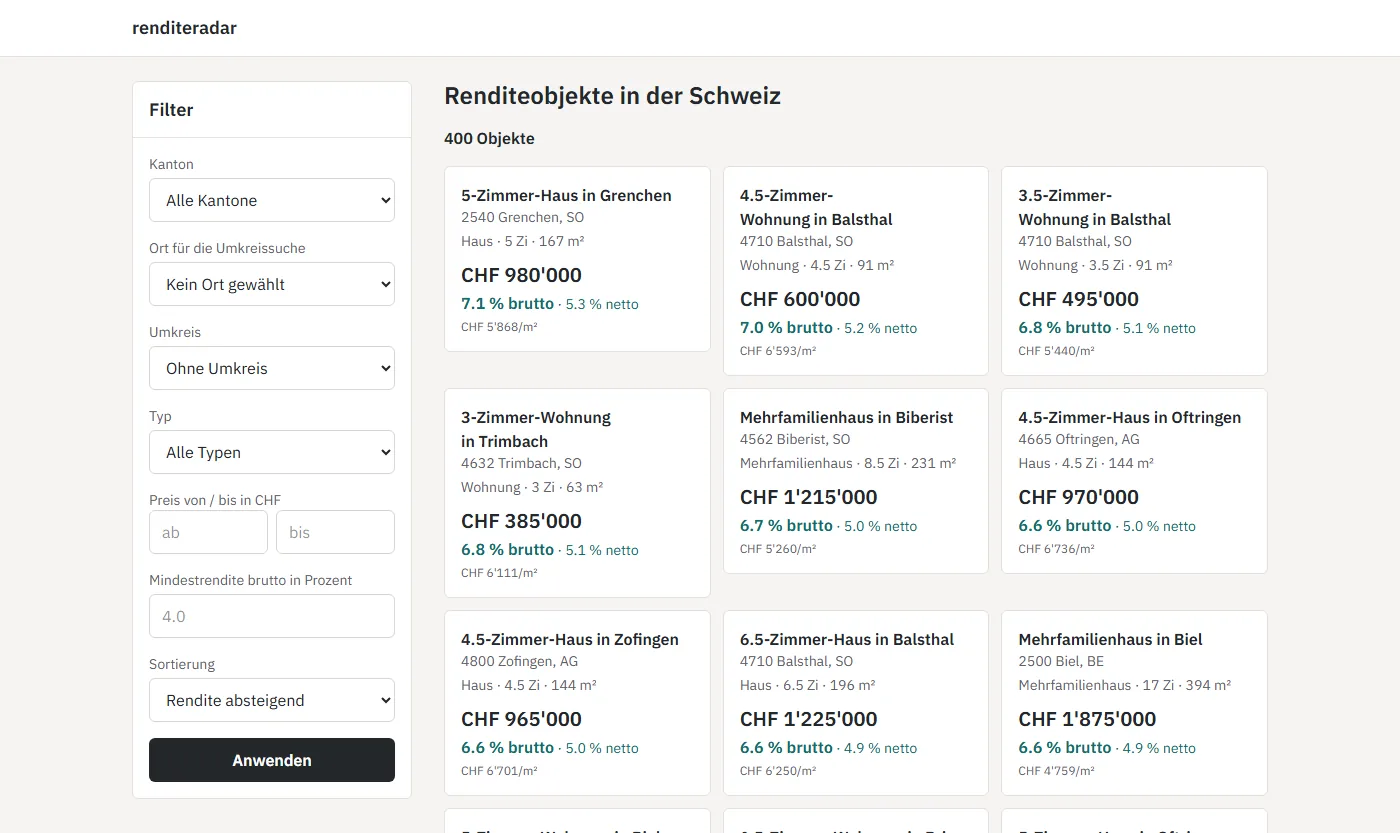
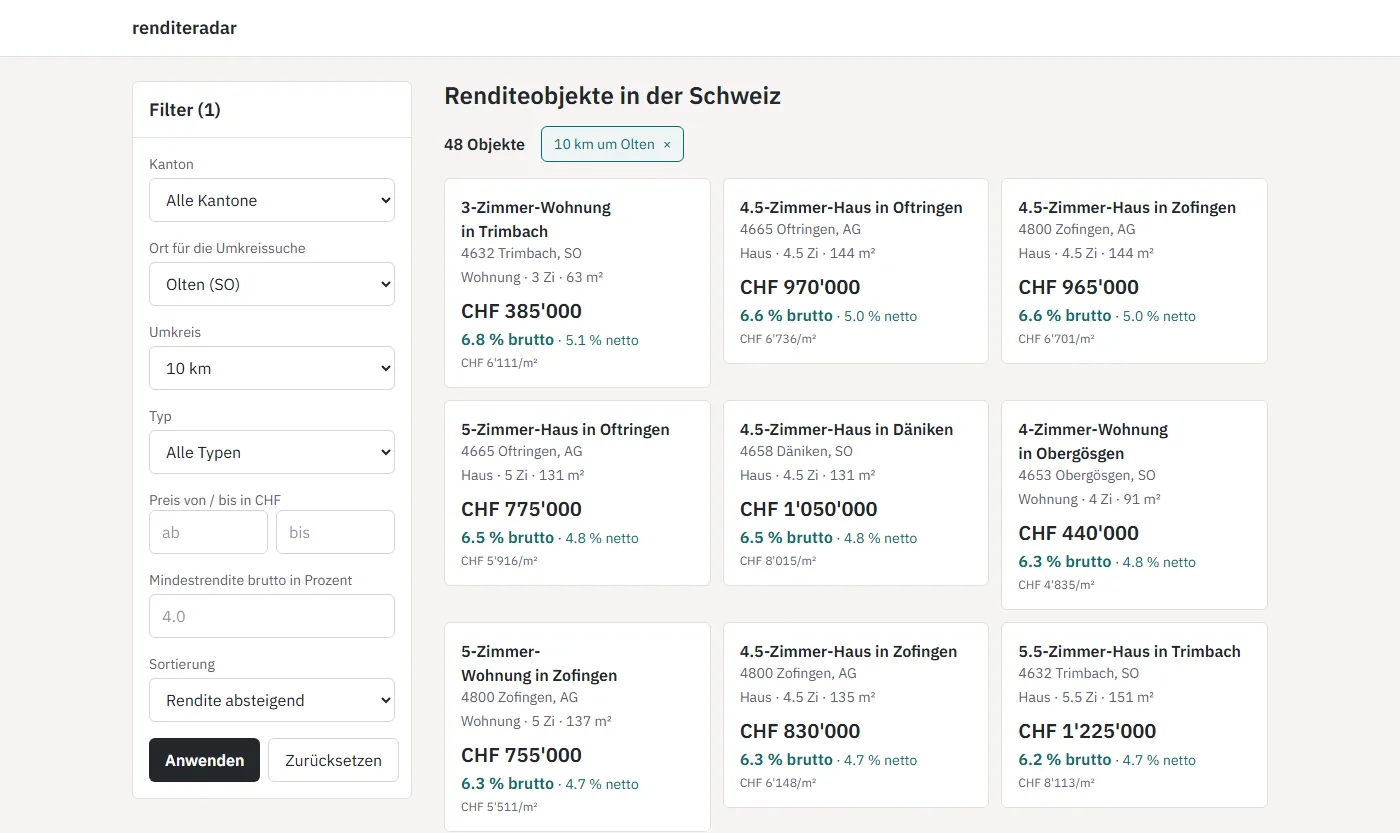
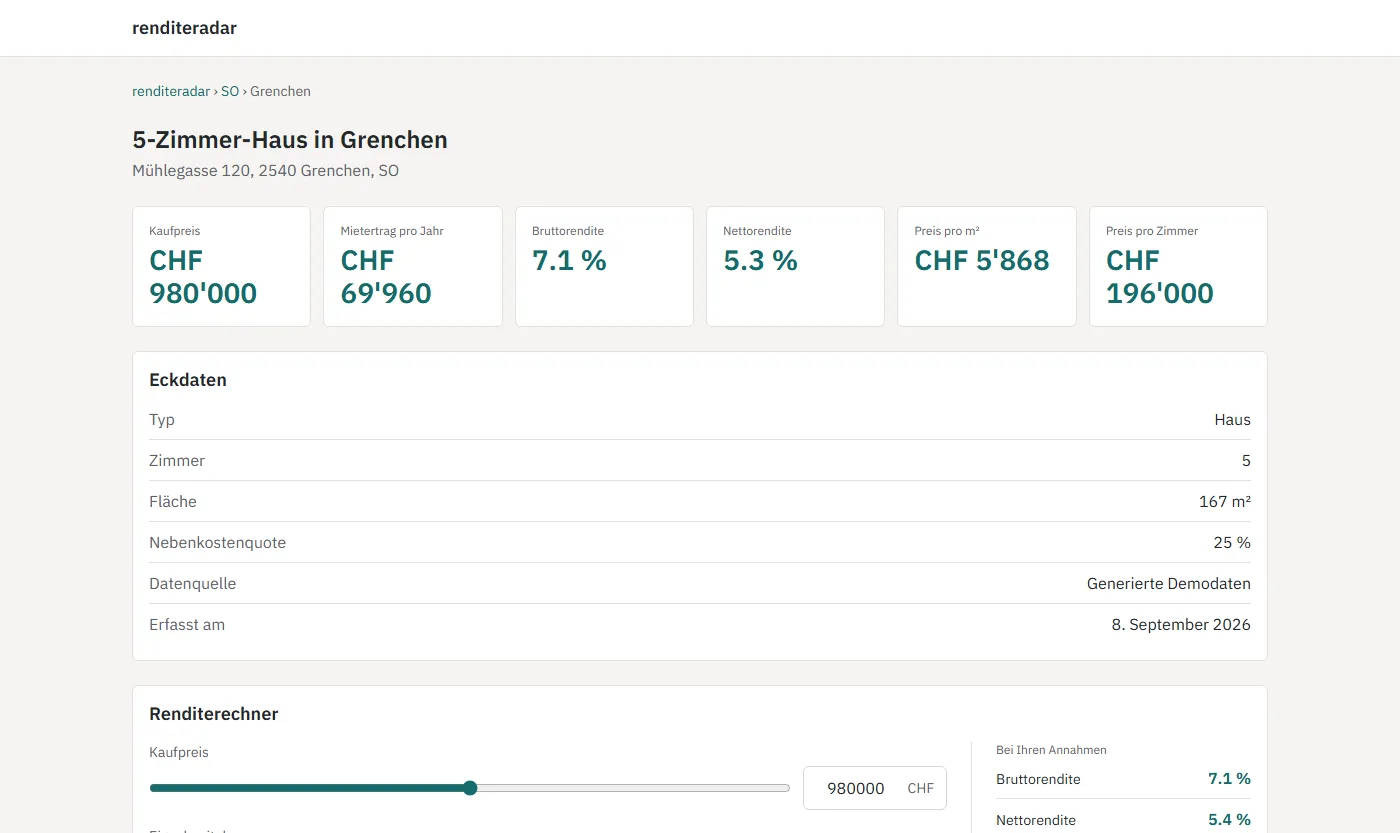
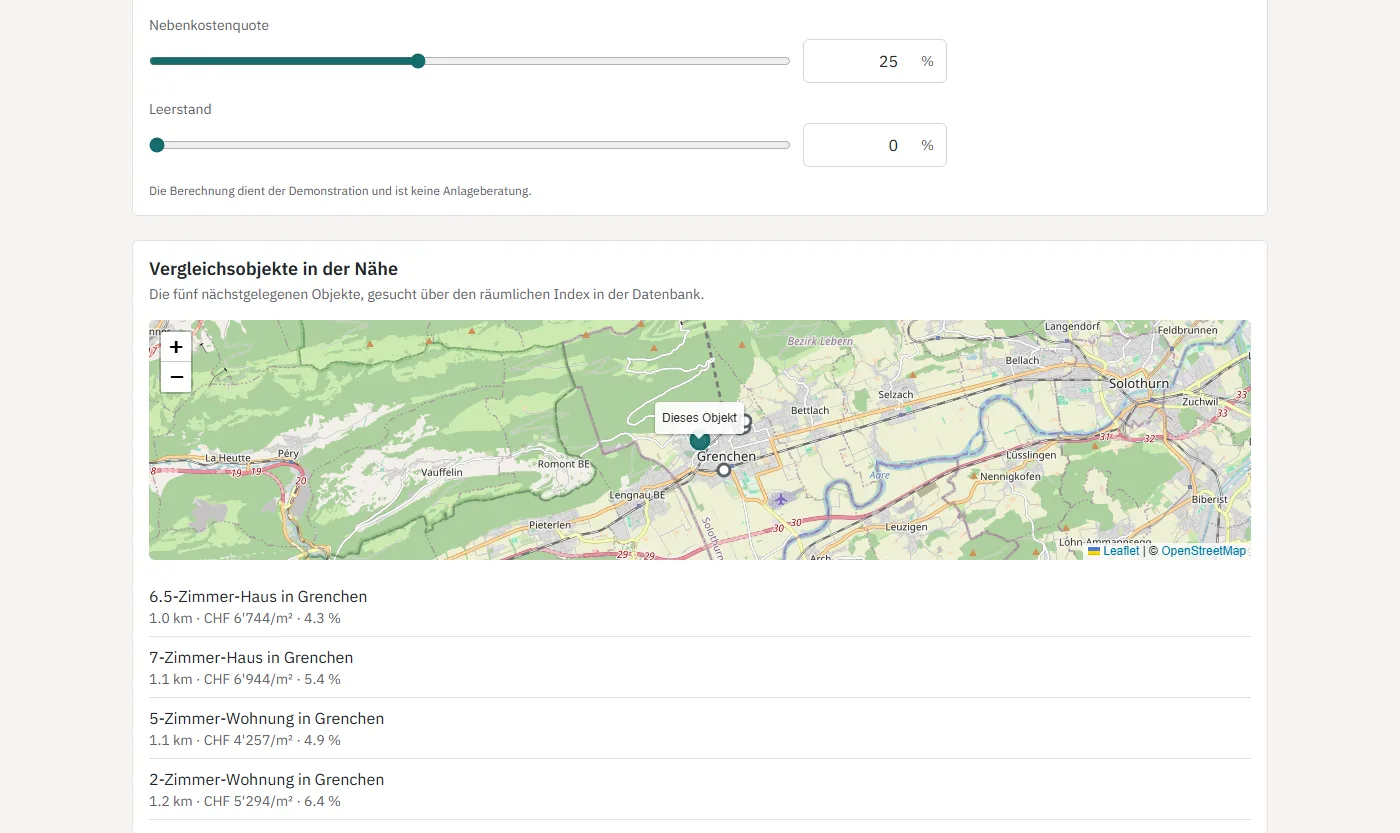
Eine Python-Pipeline erzeugt absichtlich unsaubere Rohdaten, normalisiert sie, erkennt Duplikate über einen Hash und schreibt sie mit berechneten Kennzahlen nach PostgreSQL. Eine Next.js-Anwendung zeigt die Objekte als gefilterte Liste und als statisch erzeugte Detailseiten mit Renditerechner, Vergleichsobjekten und Karte. Der gesamte Filterzustand steht in der Adresse: die Filterleiste ist ein Formular mit GET-Methode, Chips und Blättern sind Links, die Liste funktioniert ohne JavaScript. Bis zum Renditerechner gab es keine einzige Client Component, danach genau zwei.
Der Kern in einem Satz: Jede Behauptung hat einen ausgeführten Nachweis. Die Idempotenz durch einen zweiten Pipeline-Lauf (400 neu und 0 aktualisiert, dann 0 neu und 400 aktualisiert), die Indexnutzung durch den Abfrageplan, das Schreibverbot durch einen abgewiesenen Schreibversuch mit dem öffentlichen Schlüssel, HTTP 401. Kein Scraping realer Portale, keine Nutzerverwaltung, keine Zahlung: der Umfang ist auf das begrenzt, was hier neu gezeigt werden soll, und das steht im Repository ausdrücklich statt stillschweigend weggelassen.
Numbers
- properties, written idempotently: the second run changes nothing
- 400 properties, written idempotently: the second run changes nothing
- Lighthouse in all four categories on the detail page
- 100 Lighthouse in all four categories on the detail page
- nearest-neighbour search over the spatial index, proven in the query plan
- 0.16 ms nearest-neighbour search over the spatial index, proven in the query plan
Screenshots
Ein räumlicher Index, der nicht benutzt wurde
Die Suche nach den fünf nächstgelegenen Objekten war als Verknüpfung der Tabelle mit sich selbst geschrieben. Sie lieferte die richtigen Ergebnisse in 0.63 Millisekunden, und bei 400 Zeilen sieht das nach fertig aus. Der Abfrageplan zeigte aber einen sequenziellen Durchlauf über alle Zeilen mit anschliessendem Sortieren: der GiST-Index stand da und wurde nicht angefasst. Ein Index für die Suche nach dem nächsten Nachbarn setzt voraus, dass eine Seite des Vergleichs feststeht. Der Bezugspunkt steht jetzt als skalare Unterabfrage im Ausdruck statt als Partner der Verknüpfung. Postgres wertet ihn einmal vorab aus, für den Planer ist er eine Konstante, und erst dann kann der Index den Distanzoperator bedienen. Der Plan zeigt danach einen Index Scan, die Zeit fällt auf 0.16 Millisekunden. Die Lehre steckt nicht in der Zahl, sondern darin, wo sie stand: die eine Variante wächst linear mit der Tabelle, die andere nicht, und bei 400 Zeilen ist das auf der Uhr unsichtbar. Der Unterschied steht im Plan.
Stack
- Frontend
- Next.js 16 mit App Router
- React 19
- TypeScript strict
- Server Components als Vorgabe
- zwei Client Components im ganzen Projekt
- 400 statische Detailseiten mit Erneuerung im Hintergrund
- Metadaten, JSON-LD und Sitemap über Dateikonventionen
- Design and map
- Tailwind CSS v4
- IBM Plex Sans über next/font
- Design-Token aus dem Mockup als CSS-Variablen
- Leaflet mit OpenStreetMap, nur im Browser nachgeladen
- Database
- PostgreSQL 15 auf Supabase, Region Zürich
- PostGIS 3.3
- eine Tabelle mit 23 Spalten und 6 Indizes
- zusammengesetzter Index für die Listenfilter
- GiST-Index auf einer erzeugten Geography-Spalte
- Row Level Security mit genau einer Policy für select
- Pipeline
- Python 3.13
- psycopg 3
- Generator mit festem Startwert
- Normalisierung und Duplikat-Hash
- idempotenter Upsert in einer Transaktion
- Checks and CI
- 15 Tests mit pytest
- 36 Tests mit Vitest
- ruff, ESLint, Prettier, tsc
- GitHub Actions mit drei Workflows
- Lighthouse gegen die laufende Seite
- Operations
- Vercel
- Deployment aus main
- Produktionsadresse aus der Umgebung abgeleitet
Status and reading
All six milestones complete, each with a git tag and evidence. Demo public on Vercel, source public on GitHub under the MIT licence. The 400 properties are generated; only the 62 municipalities with coordinates and price levels are real.